AI 模型 SBOM 指南
如何為 HuggingFace 模型產生 CycloneDX ML-BOM(機器學習元件清單)並讀懂結果。你給模型 id,BomLens 會透過網路取得模型卡的後設資料——不需要原始碼,也不需要下載模型權重。
運作方式
AI 模型的「元件清單」就是它的模型卡:識別碼、架構、任務、授權條款、供應者、資料集,以及檔案的完整性。BomLens 以 OWASP AIBOM Generator 讀取 HuggingFace 模型卡,建立一份以模型與它所參考的資料集為中心的 CycloneDX 1.7 ML-BOM,接著加上一輪 G7 最低要素符合性檢查(建議性質)。由於模型沒有套件相依性,因此不會產生安全 (CVE) 報告。
模型是這份文件所描述的對象:它位在 metadata.component,也就是 CycloneDX 用來記載「這份 SBOM 是關於什麼」的位置,而它所參考的資料集則以相依項目的形式放在 components[] 底下。讀取 ML-BOM 的工具應該到那個位置找模型,而不是到元件清單裡找。
模型卡只列出訓練資料集的名稱就結束了。BomLens 會逐一到 HuggingFace 查詢,把查到的內容——宣告的授權條款、它所衍生自的上游資料集,以及內容雜湊值——以獨立項目的形式寫進 SBOM,並以相依關係連到模型。讀不到的資料集(已撤下、改名,或屬於他人的私有儲存庫)會保留名稱並標示為無法讀取,不會為它憑空補上授權條款。訓練資料揭露這一軸也由此決定:要成為 open-data,必須至少有一個資料集真的打開了;模型卡列了名稱但誰都取不到,讀出來會是 declared-unverified。
完整的工具流程請看各輸入類型的流程。
開始之前
你需要兩樣東西。
- 已安裝並正在執行的 Docker 引擎。如果還沒有,請先看快速開始的需求說明。
- 一種執行 BomLens 的方式。桌面版應用程式不需要下任何指令;要用指令列的話,快速開始說明了如何 clone 儲存庫。AI 模型掃描需要另一個內含 OWASP AIBOM Generator 的映像檔。它是 opt-in 的,而且會連上網路 (HuggingFace),因此與基礎映像檔分開發佈。
這個映像檔的下載量約 3.5 GB,比基礎掃描器映像檔(約 250 MB)大得多。依連線速度而定,第一次下載可能要花上數十分鐘,請預留時間再開始。只需要下載一次。
事先下載並非必要。--model 預設就使用這個映像檔,缺少時會自行取得;網頁介面與桌面版應用程式也會在第一次 AI 模型掃描時取得它,並顯示進度。要改用其他標籤,請設定 SBOM_AIBOM_IMAGE。
執行方式
從網頁介面
用桌面版應用程式,或你平常已經在跑的網頁介面都可以。只要 Docker 可連線,AI 模型磁磚就會啟用,而 aibom 映像檔會在第一次掃描時取得並以獨立容器執行——這也是第一次執行啟動特別慢的原因。
直接以 aibom 映像檔本身啟動網頁介面,掃描就會在同一個行程內完成,不需要第二個容器。在無法使用 Docker socket 的環境就需要這種做法。
SBOM_SCANNER_IMAGE=ghcr.io/sktelecom/bomlens-aibom:latest ./scripts/scan-sbom.sh --ui
#   Windows:雙擊 sbom-ui.bat 之前先設定 SBOM_SCANNER_IMAGE
在新掃描的來源磁磚中選擇 AI 模型,以 org/model 的格式輸入 HuggingFace 模型 id(例如 google-bert/bert-base-uncased 或 Qwen/Qwen2.5-0.5B——不是集合名稱,也不是完整 URL),然後執行。
從 CLI
把模型 id 傳給 --model:
./scripts/scan-sbom.sh --project bert-base --version 1.0.0 \
  --model "google-bert/bert-base-uncased" --generate-only
--model 與 --target、--analyze、--git、--merge 互斥。它會自動下載 bomlens-aibom 映像檔,產生開放原始碼授權聲明與風險報告,並略過安全報告(模型沒有套件層級的 CVE)。
私有與受管制 (gated) 的模型
公開的模型 id 可以匿名解析。私有儲存庫,或是你已獲准存取的受管制 (gated) 儲存庫,需要在 HF_TOKEN 中提供具備 read 權限的 HuggingFace 存取權杖:
HF_TOKEN=hf_... ./scripts/scan-sbom.sh --project my-llm --version 0.9.0 \
  --model "my-org/my-llm" --generate-only
HUGGING_FACE_HUB_TOKEN 也可以使用。權杖的值只以名稱傳入容器,絕不會作為指令列參數,因此不會出現在行程清單中,也不會寫進 SBOM 或任何報告。
這正是讓你在發佈模型之前先檢視它的做法:先推到私有儲存庫,產生 ML-BOM,把符合性報告指出的缺漏補起來,然後才把儲存庫轉為公開。受管制的儲存庫還需要該權杖所屬帳號的存取申請已獲核准——光有權杖並不夠。解析模型的訓練資料集用的是同一個權杖,所以資料放在私有儲存庫的模型也需要它。
網頁介面會從啟動它的環境讀取同一個變數,因此請以 HF_TOKEN=hf_... ./scripts/scan-sbom.sh --ui 的形式啟動。介面上沒有權杖輸入欄:伺服器不保存任何認證資訊,而透過 HTTP 傳來的權杖會殘留在它的日誌裡。
掃描模型檔案
上面所有做法都從模型 id 出發,也就預設模型在 HuggingFace 上。實際上常常不是這樣:供應者直接交付權重檔、模型是內部微調出來的,或是那台機器根本沒有網路。這時直接指向檔案:
./scripts/scan-sbom.sh --project internal-llm --version 1.0.0 \
  --model-file ./models/internal-llm-q4.gguf --generate-only
在網頁介面中,請在 AI 模型底下選擇模型檔案並上傳(最大 8 GB;超過就該用 CLI,因為它會就地讀取檔案,不做任何傳輸)。
唯一的資料來源是檔案自身的標頭,而且不會下載任何映像檔——這是在基礎映像檔中離線執行的。格式由魔術位元組 (magic bytes) 而非檔名決定,兩者不一致時會記錄在元件上,而不是默默地更正過去。
| 格式 | 檔案能告訴我們的資訊 |
|---|---|
| GGUF | 模型名稱、授權條款、架構、量化資訊、張量數量 |
| safetensors | 張量數量、dtype、參數數量,以及選用的 __metadata__ 區塊所宣告的內容(通常是授權條款) |
PyTorch(.pt/.pth/.ckpt)、pickle |
壓縮檔的內部結構,以及權重是 pickle 格式這件事 |
| npz、npy | 內部成員清單 |
| ONNX | 格式本身(更深入的後設資料需要 protobuf 剖析器) |
每一種格式都會附上檔案大小與整個檔案的 SHA-256,這是把文件與你收到的產出物綁在一起的依據。檔案沒有宣告的欄位會直接省略:權重不帶授權條款的模型,產出的 SBOM 就沒有授權條款,風險評估此時會讀成 review,不會把沉默當成許可。
載入它會執行程式碼嗎?
pickle 不是資料格式。載入的那一刻,資料流指示解譯器執行什麼就執行什麼,所以這種格式的檢查點本身就是一項風險——與它的授權條款無關,也與任何 CVE 無關。對 HuggingFace 上的模型,BomLens 會回報 Hub 自己的掃描結果。沒有人發佈過的檔案沒有這種紀錄,因此改在本機掃描,用的是 picklescan——與 Hub 相同的工具。
判定結果會落在模型元件上,並成為風險評估中檔案安全這一軸的依據:
| 判定 | 含意 | 評估 |
|---|---|---|
| 發現會執行程式碼的全域項目 | 可以觸及 os.system 這類危險的全域項目 |
caution |
| 發現需檢視的全域項目 | 可能是程式碼的東西,通常是自訂類別 | review |
| 未發現會執行程式碼的全域項目 | pickle 內容已經剖析,其中沒有這類項目 | ok |
| 此格式不會執行程式碼 | GGUF、safetensors、ONNX、單純的 npy | ok |
| 無法讀取 | 檔案無法剖析 | review |
中間兩列有兩件事值得知道。「發現需檢視的全域項目」在完全正當的檢查點中很常見——模型帶有自己的類別就足以觸發——所以它是請人來看一眼,而不是拉警報。而乾淨的結果只回答了一個問題:它說的是權重在載入時不會執行程式碼,不是說這個檔案什麼問題都沒有。這是 pickle 分析,不是惡意程式掃描。
.npz 會被打開,而且只檢查真正含有 pickle 的成員:dtype 為 object 的 numpy 陣列會把內容存成 pickle,這正是酬載藏身在看似數值壓縮檔裡的路徑。沒有這種成員的檔案會回報為不適用,而不是乾淨,因為並沒有檢查到任何東西。
如果掃描根本無法執行,就不會寫下任何判定,評估中也不會出現檔案安全這一軸。沒掃描就讀成「未掃描」,絕不會讀成安全。
這條路徑做不到的事
有兩件,出於設計。它沒有模型卡,所以 G7 中詢問訓練資料、預期用途與評估的檢查會回報為缺漏——這是準確的,因為檔案對這些一字未提。另外它描述的是單一檔案:分成多個分片 (shard) 的模型,目前是一個分片掃描一次。
讀懂結果
在網頁介面中,AI/ML SBOM 會在左側導覽多出兩個區段。
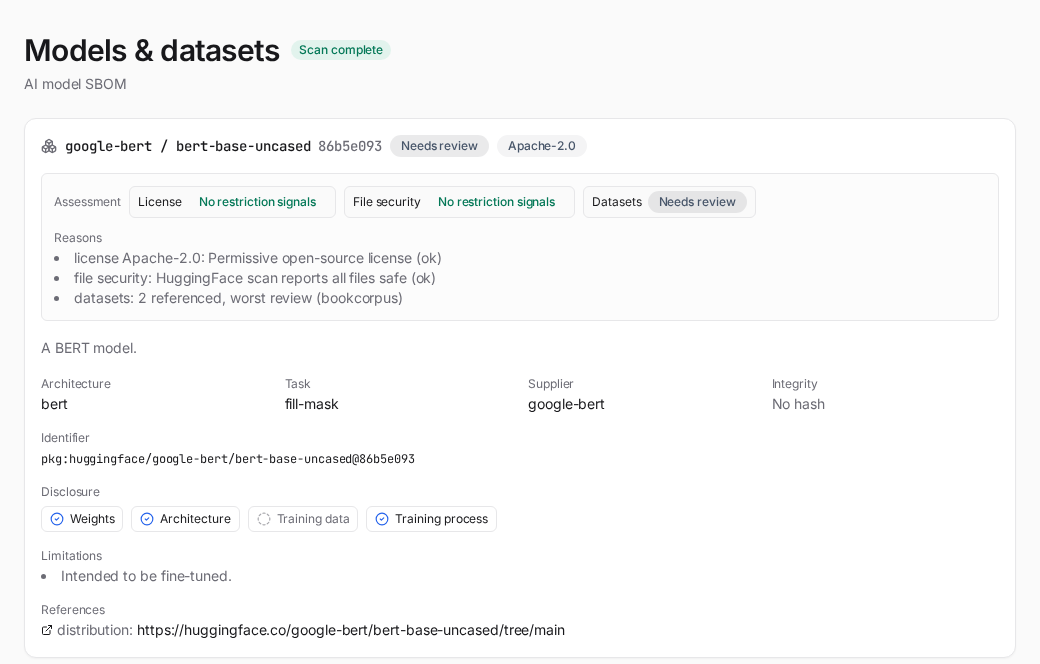
模型與資料集——每張模型卡的識別碼、架構、任務、授權條款、供應者與完整性,一組四軸揭露面板(權重/架構/訓練資料/訓練過程,以 BOM 中記載的內容為準),以及一張列出模型所參考資料集的表格,附上每個資料集的授權條款、內容雜湊值與上游來源。
SBOM 符合性——對 AI 模型 SBOM 來說,這個區段會在基本的格式符合性檢查之外,加上 G7 最低要素檢查(全部為建議性質),並依 G7 的七個叢集分組。每個要素都會說明它是什麼,以及如何滿足它。下一節解釋這些數字與標記的含意。
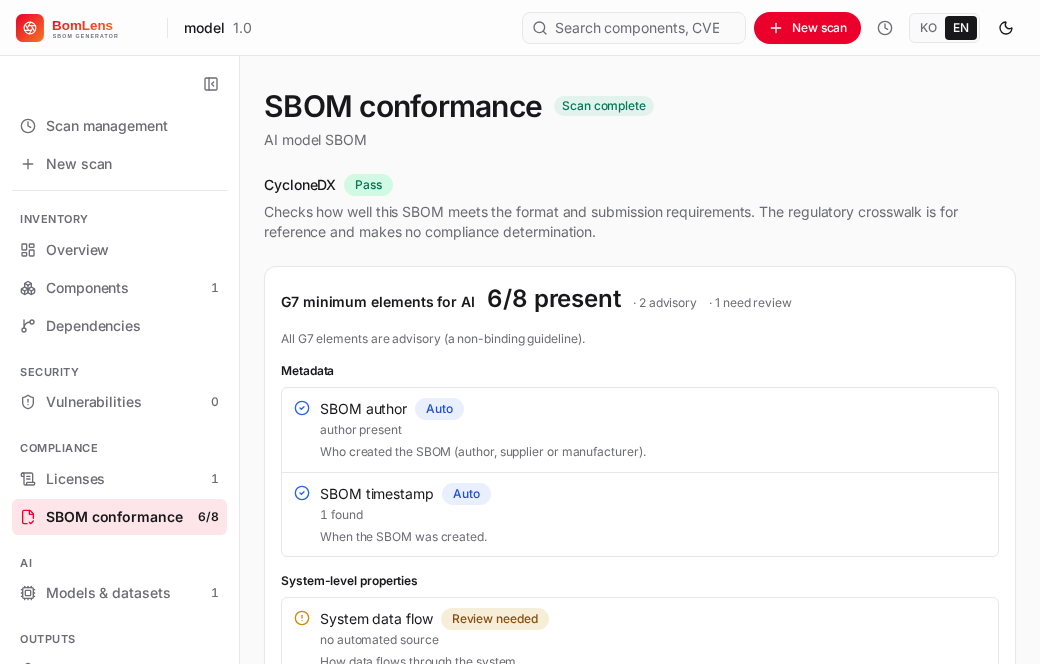
同樣的資料也在產出物裡:ML-BOM(_bom.json,CycloneDX 1.7)與符合性報告 (_conformance.*)。
如何讀符合性報告
G7 區塊開頭是一行像「N / 41 已具備」的摘要數字。分母只計入有自動化來源的檢查——51 項中的 41 項——所以這個數字說的是工具憑自己能驗證到什麼程度。那 10 項只能人工檢視的要素會另外以「需人工檢視」的件數列在旁邊,而自動檢查中什麼都沒找到的,則計為建議件數。
每項檢查都有三種狀態之一。通過 (pass) 表示該要素存在於 ML-BOM 中。建議 (warn) 表示它缺漏或無法確認;那 10 項只能人工檢視的要素一律是這個狀態,並標示為需人工檢視。未通過 (fail) 在 G7 檢查中實際上不會出現:每一項 G7 要素都屬建議性質,因此少了一項絕不會讓整份 SBOM 未通過。整體的未通過判定只可能來自基本格式檢查,也就是 CycloneDX 的必要項目。
有些列讀出來是不適用,並在摘要中另有自己的件數。這些是文件沒有給出任何判斷依據的檢查:對零個元件計算涵蓋率,或是在只以模型本身為對象的文件裡詢問元件之間的相依關係。它們會從分子與分母兩邊同時扣除,而不是算成已具備,因為算成已具備會讓一張宣告較少的模型卡,排在有宣告資料集、因此被實際衡量的模型卡之上。它們也不是需人工檢視的項目——檢視者根本沒有東西可看。因此,列出訓練資料集的模型卡實際被衡量的檢查更多,分母較小並不代表結果更好。
每一列上的來源標記會說明已滿足的值從哪裡來:
- 自動(22 項)——直接從 ML-BOM 的欄位讀取。
- 推斷(15 項)——由 BOM 中的訊號導出,而非某個專用欄位。
- 已宣告(4 項)——只有在人或資訊清單提供了這個值時才會出現。
- 需人工檢視(10 項)——沒有自動化來源,必須由人確認。同一份結果會以三種格式輸出:給機器讀的
{Project}_{Version}_conformance.json(CI 關卡、比對差異)、表格形式的_conformance.md,以及視覺化摘要的_conformance.html。每一種格式也都帶有法規對照;在 JSON 中它是regulatoryCrosswalk物件,只有在至少評估過一項有對應的檢查時才會出現。
報告不只告訴你哪裡有缺漏,也告訴你怎麼補。每一項有自動化來源、卻仍然缺席的建議要素,都會附上一段 CycloneDX 片段與權威文件的連結——在 HTML 中收在該列的「佐證 · 方式」欄位裡,在 Markdown 中則彙整在「如何填補缺漏」底下。已通過與只能人工檢視的要素不會列入,因此文件寫得完整的模型什麼都不會顯示。
實際範例
親手跑一次會讓後面的內容好讀得多。FINAL-Bench/Aether-7B-5Attn 是發佈在 HuggingFace 上、採用 Apache-2.0 的基礎模型,權重、架構、訓練資料與訓練過程全部揭露,正好展示文件完整的模型卡會產出什麼。
./scripts/scan-sbom.sh --project Aether-7B-5Attn --version 1.0 \
  --model "FINAL-Bench/Aether-7B-5Attn" --generate-only
這次執行回報 result=pass,41 項 G7 要素中已具備 33 項。模型叢集的 14 項檢查全部通過,揭露面板的四個軸都讀為開放:
| 軸 | 值 |
|---|---|
| 權重 | open-weight |
| 架構 | open-architecture |
| 訓練資料 | open-data |
| 訓練過程 | open-training |
由於模型卡列出了資料集,BomLens 逐一查詢了模型訓練所用的全部七個資料集(FineWeb-Edu、SmolLM 語料庫、FineMath、open-web-math、一組 OpenCoder 程式碼語料庫,以及 HAERAE-HUB 的兩組韓文資料集),並記錄下每一個所宣告的內容。資料集屬性的十項要素中有八項回報為已具備。剩下的兩項是資料的統計屬性,以及它是否含有個人資料或受著作權保護的內容;這兩項都無法從儲存庫讀出,因此報告不做猜測,而是請人確認。
正是這番查詢讓接下來這件事顯現出來。七個資料集中只有三個帶有授權條款——FineWeb-Edu 家族是 odc-by,OpenCoder 語料庫是 MIT——另外三個完全沒有宣告:HAERAE-HUB 的兩組與 open-web-math。若只清點資料集名稱,這個模型的訓練資料會被說成完全開放。實際讀過資料集後才看得出來:一個以 Apache-2.0 發佈的模型,它的訓練語料有一部分授權條款不明。這不是工具該做的判斷;這是檢視者在發佈之前需要知道的事,而它只有在逐一查詢每個資料集之後才會浮現。
這次執行產生的報告就在這裡,可以直接打開:基礎模型的符合性報告,它的開頭就是 AI 合規概況在 JSON 與 Markdown 中所帶的同一份 G7 彙整。加上 --lang ko 或 --lang zh-TW 可以得到韓文或正體中文的同一批報告;無論哪一種,SBOM 與 JSON 報告都維持英文。
下一步
報告不等於檢視完成。有些要素工具可以補上,有些只有人能回答。
- 把有自動化來源但回報為空的要素填好,然後重新掃描。能滿足每一項的寫法就在報告中它自己那一列。
- 自行回答那 10 項只能人工檢視的要素——像是訓練資料的敏感度或預期應用領域,這些沒有任何模型卡欄位能證明。
- 另外確認這個工具不看的事項,例如訓練資料集的授權條款與個人資料。
如果你是在公司內部準備發佈 AI 模型,核准流程與發佈前的檢查項目就在旁邊:請看 SK Telecom 開放原始碼指南中的發佈 AI 模型。
G7 檢查清單
「G7 Software Bill of Materials for AI — Minimum Elements」是 2026 年 5 月以 G7 名義發佈的指引,由德國 BSI 與義大利 ACN 主導。它定義了 50 項最低要素,分為七個叢集,說明 AI 模型的 SBOM 應該承載什麼:誰做了這個模型、它是什麼、用什麼資料訓練、如何受到保護,以及它的表現如何。這是不具約束力的建議,不是法規。
它對法規仍然重要。EU AI Act 的高風險與透明性義務自 2026 年 8 月 2 日起適用,而其 Annex IV 所要求的技術文件與 G7 叢集有相當程度的重疊。BomLens 不認證是否符合這兩份文本中的任何一份。符合性報告給你的是可見性:它逐項顯示你的模型文件已經涵蓋了什麼、還有什麼必須由人提供——這是一條具體的準備途徑,不是合規判定。
BomLens 把這 50 項要素呈現為 51 項檢查。模型開放性(權重、架構、訓練資料與訓練過程是否揭露)在 G7 原文中是 Model license 要素的一個面向,但它值得單獨看,所以另立一列。
| 叢集 | 檢查數 | 其中需人工檢視 |
|---|---|---|
| 後設資料 | 10 | 0 |
| 系統層級屬性 | 9 | 4 |
| 模型 | 14 | 0 |
| 資料集屬性 | 10 | 2 |
| 基礎設施 | 2 | 0 |
| 安全性屬性 | 4 | 3 |
| 關鍵績效指標 | 2 | 1 |
有 10 項要素沒有自動化來源——像是預期應用領域或資料集敏感度,這些沒有任何模型卡欄位能證明。BomLens 不做猜測,而是把它們列為需人工檢視。
法規對照
符合性報告會把每一項有對應法規的檢查,連到它所觸及的具體文件化義務。它回答的是檢視者的問題:某項檢查結果不足時,這個缺漏牽涉到哪一條法規要求?參考出處放在檢查表格中它所屬要求的下方,而明細之上的法規對照區段則把涵蓋範圍彙總起來——每個框架一列,統計已對應的檢查中有多少項已具備、多少項缺漏、多少項只能人工檢視。
有兩個框架涵蓋所有被分析的 SBOM,無論是不是 AI:
- EU Cyber Resilience Act (EU CRA)——透過 BSI TR-03183-2 連結,那是德國為 CRA 合規所撰寫的技術指引,也是目前公開文件中最詳盡的 SBOM 欄位規格(CRA 本文並未指名任何資料欄位)。TR-03183-2 是國家層級的指引,而將承載具約束力條文的歐洲調和標準目前仍是草案。
- 美國 SBOM 最低要素——2026 年版最低要素的 17 個資料欄位與 6 項實務作法,由 CISA、NSA 與 FBI 會同十五個國際夥伴發佈,取代 2021 年的 NTIA 要素。聯邦層級的 SBOM 蒐集後來已收斂為各機關依風險自行決定,但這些欄位仍是個別機關實際會要求的實務基準。
對 AI SBOM 來說,另有兩個框架對應到 G7 要素:
- EU AI Act——Annex IV 的技術文件章節 (Regulation (EU) 2024/1689, Article 11(1))。
- AI 基本法(韓國)——該法關於透明性 (제31조)、安全性與風險管理 (제32조)、高影響 AI (제33·34조) 與影響評估 (제35조) 的條文。這部法律訂的是框架層級的義務,因此這些連結比 EU 的更為粗略。
法規對照是準備用的輔助,不是合規判定。BomLens 不認證是否符合上述任何一份文本,報告也在該區段中明言這一點。每一組對應都附有建立該連結的解釋依據,讓人可以自行判斷;法規對照也絕不會改變任何檢查的狀態或整體結果——它只是把檢查已經產生的結果重新分組。
對應關係放在 docker/lib/regulation-crosswalk.json,以檢查 id 為鍵——AI 檢查用 G7 要素 id,基本格式檢查用一般的 CycloneDX 檢查 id。它刻意保守:只有具備可辯護對應關係的檢查才會納入(目前 38 項),並且有測試會拿每一個已對應的 id 去核對登錄表,讓檢查更名時法規對照不會默默失準。
AI 合規概況
對 AI SBOM,BomLens 還會產出一份單頁的 AI 合規概況 (_ai-profile.{json,md,html}),把原本散落在各個產出物中的內容彙整到一處:各叢集的 G7 狀態、法規對照,以及授權條款被標記待檢視的元件(AI 行為限制或非商業)。它不執行任何掃描,也不做任何合規判定——它只是把流程已經產生的結果重新分組,讓檢視者能一眼讀完整體樣貌。它會在 AI 模型 (--model) 與供應者 SBOM (--analyze) 兩條路徑上產生,對一般(非 AI)SBOM 則不做任何事。
模型風險評估
AI 合規概況還為每個模型帶上一項可用性判定,回答開發團隊最先問的問題:我們可以用這個模型嗎,在什麼條件下?每個模型——以及每個資料集項目——都會就流程有佐證的那些軸進行評估,並得到四種判定之一。
| 判定 | 含意 |
|---|---|
| 未發現限制訊號 (ok) | 只有已知的無限制訊號——例如寬鬆式的授權條款。 |
| 有條件使用 (conditional) | 滿足所列條件即可使用——例如 Llama 社群授權條款的使用者數門檻與命名規則,或是 copyleft 授權條款的聲明義務。 |
| 注意 (caution) | 存在已知的阻斷訊號——例如非商業或僅限研究的授權條款。 |
| 需人工檢視 (review) | 工具無法判定:無法辨識的授權條款、缺少授權條款,或是讀不到的資料集。必須由人來看。 |
檔案安全這一軸讀的是 Hugging Face 自己對每個儲存庫執行的掃描結果——逐檔以 ClamAV 找惡意程式,以 picklescan 找可執行的 pickle import。BomLens 透過後設資料 API 讀取這些結果,一個檔案都不下載,記錄下最差的狀態與被標記的檔名,並註明權重使用的是 pickle 家族的格式(載入時可能執行程式碼)還是像 safetensors 這樣安全的格式。掃描還在等待中的模型讀成需人工檢視,不是安全。設定 ENRICH_HF_SECURITY=false 可以略過這項查詢。
授權條款判定來自一份人工整理的知識庫 (docker/lib/ai-risk-knowledge.json),涵蓋 Hugging Face 完整的授權條款標籤清單。每一筆都記錄了是否允許商業使用、再散布與製作衍生物,適用哪些條件,以及授權條款原文的連結;概況會把摘要與條件印在判定旁邊,讓依據隨著判定一起移動。知識庫不認識的授權條款會落到需人工檢視——絕不猜測。模型的綜合判定取它所評估各軸中最差的一項,而什麼都沒評估到的軸會顯示為未評估,不會被讀成安全。
還有兩項檢查讓授權條款判定更深入。對標籤為 other 的模型,BomLens 會讀取儲存庫的 LICENSE 檔案(一個小小的文字檔——仍然不下載權重),並在其中搜尋非商業、僅限研究或禁止製作衍生物之類的限制性字句;命中的字句會逐字引用在判定旁邊,讓報告說的是「因為這句話所以需要檢視」,而不只是「未分類」。沒有命中仍然讀成需人工檢視——樣式沒中什麼也證明不了。而對微調過的模型,BomLens 會沿著所宣告的上游模型鏈(base model,最多五代)比對授權條款:當某個上游帶有條件會延伸到衍生物的授權條款(Llama、Gemma、RAIL 家族、非商業的 CC),而模型自己卻宣告了別的條款時,這個不一致會被標為注意——這是 hub 上常見的標示錯誤,只看標籤的檢查看不出來。
資料集這一軸把所參考的資料集彙整進模型的判定。每個資料集項目會就它自己的授權條款,以及它所宣告的風險標記來判定:發佈者標籤如 pii(個人可識別資訊)或 not-for-all-audiences,以及存取限制(受管制或私有的儲存庫)。模型會取最差的資料集判定,並指名是哪些資料集造成的。這些標記是發佈者自己的宣告——沒有標記什麼也證明不了,所以它們只會拉高判定,絕不會解除判定。
判定可以依你實際打算怎麼用這個模型來調整。傳入 --usage 並指定 internal(內部檢視與研究)、product(整合進產品或服務)、redistribute(微調並再散布)或 outputs-only(只使用模型產生的輸出)之一,就只有約束該情境的授權條件會決定判定——例如一個非商業的模型,用於內部研究會讀成有條件使用,用於產品整合則是注意。報告一律會註明它是以哪個情境判定的;沒有 --usage 時,所有條件都計入。
./scripts/scan-sbom.sh --project my-llm --version 1.0 \
  --model "meta-llama/Llama-3.3-70B-Instruct" --usage product --generate-only
這些判定是指引,不是法律意見,每一份印出它們的報告都會這麼說。它們把檢視者需要的東西——條款、來源、未知之處——集中在一起,讓最終決定由掌握全部依據的人來做。
限制
- 工具讀不到的模型根本不會產生 SBOM。取得失敗時產生器會用通用的預設值把模型卡填滿,因此 BomLens 會檢查它的日誌並拒絕這次執行,而不是回傳一份滿是佔位值、看起來卻像通過的清單。
- 結果的完整程度只會等於 HuggingFace 模型卡本身。內容單薄的模型卡產出單薄的 ML-BOM,而 G7 檢查反映的是模型卡記載了什麼——不是對模型本身的稽核。
- 資料集項目記錄的是該資料集對自己的宣告。所宣告的授權條款是否正確,以及衍生出來的資料集是否與它的來源相容,報告都留給檢視者判斷。
- 複合的 SPDX 授權條款表達式 (
MIT OR Apache-2.0) 會整體評估,不會去解析其中的選擇,因此一個雙重授權的模型可能讀成review,即使單獨採用任一邊都會是ok。這個方向刻意保守——它絕不會低估警示——但可能過度標記;報告會寫出確切的表達式,讓檢視者自行確認。 - 符合性報告不認證是否符合 EU AI Act 或任何其他法規。它讓文件缺漏顯而易見,好讓人去補。
- 它會透過網路取得後設資料,因此不支援離線使用。私有與受管制的模型需要
HF_TOKEN(參考私有與受管制的模型)。 - 模型 id 必須是
org/model。集合名稱或完整 URL 無法解析。 ---